Les 5 meilleurs outils d’extraction OCR
Une sélection pratique pour extraire vers Excel, convertir des PDF ou développer un traitement OCR, avec les points à vérifier avant de choisir.
Le meilleur outil d’extraction OCR dépend du résultat recherché. Lire le texte d’un scan et répartir numéros de facture, totaux et articles dans des colonnes Excel cohérentes sont deux tâches différentes.
Notre sélection comprend IntoExcel.com, Adobe PDF Extract, Google Document AI, Amazon Textract et Tesseract. Ces outils répondent à des usages différents.
Article de l’équipe IntoExcel. Fonctionnalités vérifiées dans les documentations officielles et le code d’IntoExcel le 21 septembre 2026. Sélection éditoriale, sans test indépendant de précision ni classement mesuré. Les tarifs peuvent évoluer.
OCR et extraction structurée : quelle différence ?
L’OCR, ou reconnaissance optique de caractères, transforme le texte d’une image en caractères exploitables. L’extraction structurée associe ensuite les valeurs à des champs, comme « Numéro de facture » ou « Total », et organise les éléments répétés.
Définissez d’abord votre besoin : texte consultable, tableau PDF converti, structure Excel réutilisable ou composant pour une application.
| Votre tâche | Notre point de départ conseillé | À évaluer |
|---|---|---|
| Champs sélectionnés dans Excel | IntoExcel | Colonnes et mode de lignes |
| Extraire structure et tableaux PDF par API | Adobe PDF Extract | Sortie structurée et intégration |
| Application sur Google Cloud | Google Document AI | Processeur et intégration |
| Application sur AWS | Amazon Textract | Résultat de l’API et conception |
| Moteur OCR exécuté localement | Tesseract | Installation et structuration ultérieure |
1. IntoExcel : extraire les données choisies vers Excel
IntoExcel.com permet d’importer PDF ou images, de sélectionner des champs prédéfinis ou personnalisés, de vérifier le tableau et de l’exporter. C’est une application d’extraction par IA, pas un moteur OCR autonome.
Choisissez une ligne par document pour un registre ou une ligne par article pour des produits, opérations ou autres éléments répétés. Les types personnalisés sont Automatique, Texte, Nombre, Pourcentage et Devise. Texte conserve les zéros initiaux ; Nombre convient généralement aux montants.
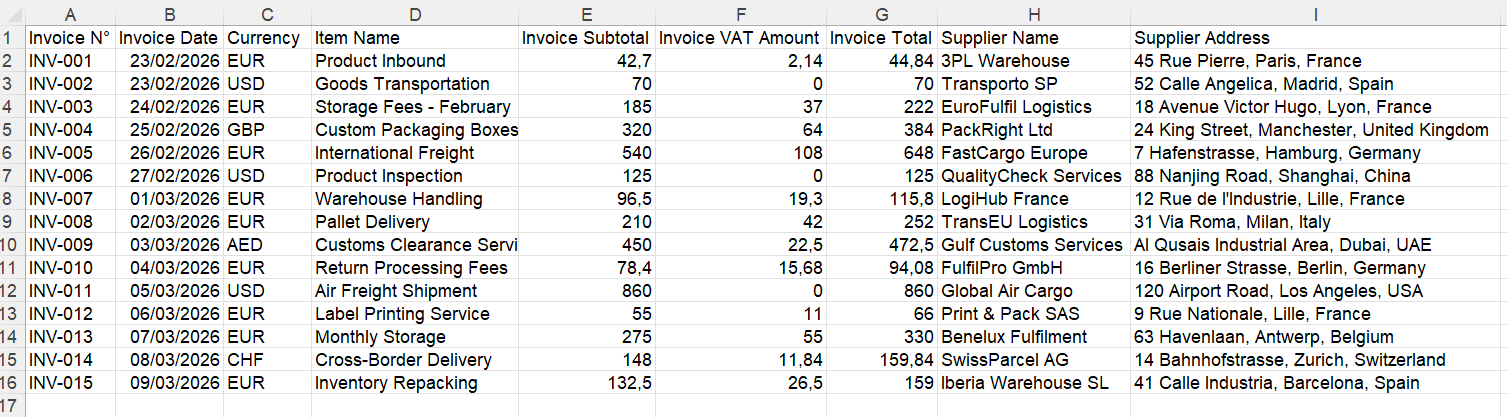
Exemple par document, avec des en-têtes en anglais. Vos champs déterminent les colonnes.
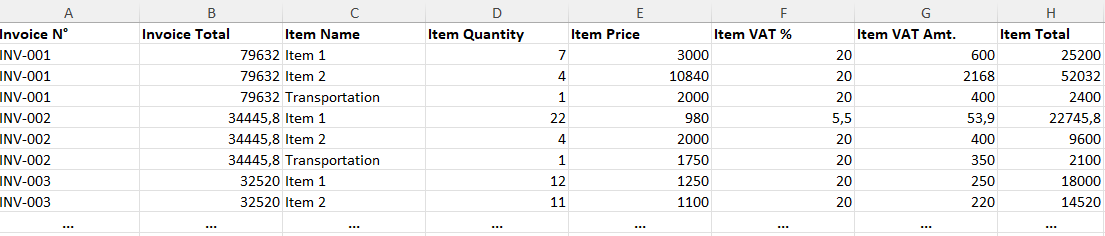
Exemple détaillé, avec des en-têtes en anglais. N’additionnez pas les totaux de document répétés sur plusieurs articles.
Les offres actuelles incluent 20 extractions gratuites par mois, Pro à 9 USD/mois pour 200 extractions et Business à 40 USD/mois pour 1 000 extractions. Consultez les tarifs IntoExcel et les conditions affichées au paiement.
À envisager si : vous voulez un tableau à vérifier et utiliser vous-même.
À contrôler : gardez un document distinct par fichier ; seul le premier est traité dans un fichier regroupé. La sortie est limitée à 500 lignes. Les valeurs absentes donnent des cellules vides et les nombres ambigus peuvent rester du texte. Vérifiez messages et résultats.
2. Adobe PDF Extract / Acrobat Services : structure et tableaux PDF
Adobe PDF Extract est une API pour développeurs, distincte du convertisseur Acrobat de bureau. Elle extrait texte, mise en forme, ordre de lecture, figures et tableaux complexes. Les tableaux peuvent être fournis en CSV ou XLSX avec la sortie structurée.
Usage conseillé : applications qui réutilisent la structure existante des PDF. Un tableau extrait n’attribue pas automatiquement un sens métier à chaque colonne ; correspondances et contrôles restent parfois nécessaires.
Tarification : 500 Document Transactions gratuites par mois. Pour Extract PDF, chaque bloc de cinq pages maximum compte comme une transaction. Les volumes commerciaux supérieurs nécessitent une offre Adobe, sans tarif public universel par page. Voir les tarifs développeurs Adobe.
3. Google Document AI : extraction spécialisée et personnalisée
Google Document AI propose OCR, analyse de mise en page et tableaux, processeurs pour factures, dépenses et relevés bancaires, ainsi qu’un Custom Extractor pour définir les champs ou entités recherchés.
Tarifs standard indicatifs en USD :
| Processeur | Base de facturation |
|---|---|
| Enterprise Document OCR | Environ 1,50 $ pour 1 000 pages facturables |
| Layout Parser | 10 $ pour 1 000 pages |
| Form Parser / Custom Extractor | 30 $ pour 1 000 pages au premier palier |
| Invoice Parser | 0,10 $ par bloc de dix pages maximum d’un document |
Ces montants concernent le traitement, pas l’application complète. Quotas gratuits, paliers et engagements peuvent modifier la facture ; hébergement de processeurs personnalisés et autres services peuvent s’ajouter. Consultez les tarifs Google.
Usage conseillé : équipes de développement ayant besoin de processeurs prédéfinis ou d’un schéma personnalisé. Prévoyez import, vérification et export autour de l’API.
4. Amazon Textract : formulaires, requêtes et factures
Textract associe OCR, tableaux, formulaires et paires clé-valeur, requêtes et Custom Queries. AnalyzeExpense cible les factures et reçus, avec champs récapitulatifs et lignes d’articles. Les Custom Queries utilisent un adaptateur adapté à vos documents et diffèrent des requêtes standard.
Exemples au premier palier, région US West (Oregon), en USD :
| Opération | Prix pour 1 000 pages |
|---|---|
| OCR simple : DetectDocumentText | 1,50 $ |
| Tables | 15 $ |
| Tables + Queries standard | 20 $ |
| Factures/reçus : AnalyzeExpense | 10 $ |
Le prix de 20 $ ne concerne pas les Custom Queries. Fonctionnalités, région et volume influencent le coût ; les formulaires ne sont pas inclus dans Tables seul. Ces analyses incluent l’OCR : n’ajoutez pas automatiquement une seconde facturation OCR. Voir les tarifs AWS.
Usage conseillé : application AWS ayant besoin de données structurées. Ajoutez intégration, stockage et contrôle au budget des appels API.
5. Tesseract OCR : moteur gratuit, traitement à gérer
Tesseract est un moteur OCR libre sous Apache 2.0. Il transforme images et scans en texte exploitable. Il n’interprète pas intrinsèquement les champs d’une facture ou le sens d’un tableau ; votre application doit assurer cette structuration.
Tarification : aucun frais d’API Tesseract si vous exécutez le moteur vous-même. Vous assumez ordinateur ou serveurs, infrastructure, maintenance et développement. Un service tiers hébergé peut facturer son propre accès.
Usage conseillé : OCR simple privilégiant contrôle local et faible coût direct. Il peut être économique si vous possédez déjà compétences et infrastructure, sans être forcément le moins cher pour un processus complet de factures. Sa sortie native n’est pas un tableau métier XLSX.
Comparer le coût complet
Ces montants sont des repères vérifiés le 21 septembre 2026, pas des devis pour votre application. Comparez le même volume et le même résultat attendu. Page, transaction Adobe, extraction IntoExcel et abonnement mensuel sont des unités différentes.
Incluez configuration, hébergement éventuel, corrections, relecture et intégration. Vérifiez les conditions actuelles de région, formule et facturation avant l’achat.
Tester avant de choisir
Utilisez les mêmes fichiers représentatifs et colonnes attendues :
- Incluez scans lisibles, PDF numériques et mises en page habituelles.
- Comparez références, dates, montants et nombres d’articles aux originaux.
- Ouvrez l’export et testez calculs numériques et zéros initiaux.
- Notez valeurs absentes ou incorrectes et corrections nécessaires.
- Comparez le travail complet, pas seulement l’import.
Pour un essai hypothétique, prenez dix documents représentatifs. C’est une proposition de test, pas une promesse de rapidité ou de précision.
Si votre priorité est une structure Excel choisie pour vos PDF ou factures, essayez l’outil d’extraction IntoExcel. Vérifiez un petit lot avant de décider si les champs et modes de lignes vous conviennent.
Prêt à essayer ?
Ne perdez plus des heures à saisir vos données. Extrayez instantanément les données de vos PDF vers Excel grâce à notre outil d’IA.
Extraction