Die 5 besten OCR-Extraktionstools
Eine praktische Auswahl für Excel-Extraktion, PDF-Konvertierung, Cloud-APIs und lokale OCR – mit Kriterien für einen aussagekräftigen Test.
Welches OCR-Extraktionstool passt, hängt vom gewünschten Ergebnis ab. Text aus einem Scan zu lesen ist etwas anderes, als Rechnungsnummern, Summen und Positionen in einheitliche Excel-Spalten zu übertragen.
Unsere Auswahl umfasst IntoExcel.com, Adobe PDF Extract, Google Document AI, Amazon Textract und Tesseract. Sie decken unterschiedliche Arbeitsabläufe ab.
Veröffentlicht vom IntoExcel-Team. Funktionen anhand offizieller Dokumentation und des IntoExcel-Codes am 21. September 2026 geprüft. Redaktionelle Auswahl, kein unabhängiger Genauigkeitstest und keine gemessene Rangliste. Preise können sich ändern.
OCR und strukturierte Extraktion unterscheiden
OCR, die optische Zeichenerkennung, wandelt Bildtext in maschinenlesbare Zeichen um. Strukturierte Extraktion ordnet Werte zusätzlich Feldern wie „Rechnungsnummer“ oder „Gesamtbetrag“ zu und organisiert wiederholte Einträge.
Entscheiden Sie zuerst, ob Sie durchsuchbaren Text, eine konvertierte PDF-Tabelle, wiederverwendbare Excel-Spalten oder eine Komponente für eigene Software benötigen.
| Aufgabe | Unser Vorschlag zum Einstieg | Wichtigster Prüfpunkt |
|---|---|---|
| Ausgewählte Felder in Excel | IntoExcel | Spalten und Zeilenmodus |
| PDF-Struktur und Tabellen per API extrahieren | Adobe PDF Extract | Strukturierte Ausgabe und Integration |
| Auf Google Cloud entwickeln | Google Document AI | Prozessor und Integration |
| Auf AWS entwickeln | Amazon Textract | API-Ergebnis und Anwendung |
| Lokale OCR-Engine betreiben | Tesseract | Einrichtung und weitere Strukturierung |
1. IntoExcel: ausgewählte Daten nach Excel extrahieren
IntoExcel.com nimmt PDFs und Bilder entgegen. Wählen Sie Standardfelder oder eigene Felder, prüfen Sie die Tabelle und exportieren Sie nach Excel. Es handelt sich um eine KI-Extraktionsanwendung, nicht um eine eigenständige OCR-Engine.
Nutzen Sie eine Zeile pro Dokument für Register oder eine Zeile pro Position für Produkte, Transaktionen und andere wiederholte Einträge. Eigene Felder unterstützen Automatisch, Text, Zahl, Prozent und Währung. Text bewahrt führende Nullen; Beträge benötigen meist Zahl.
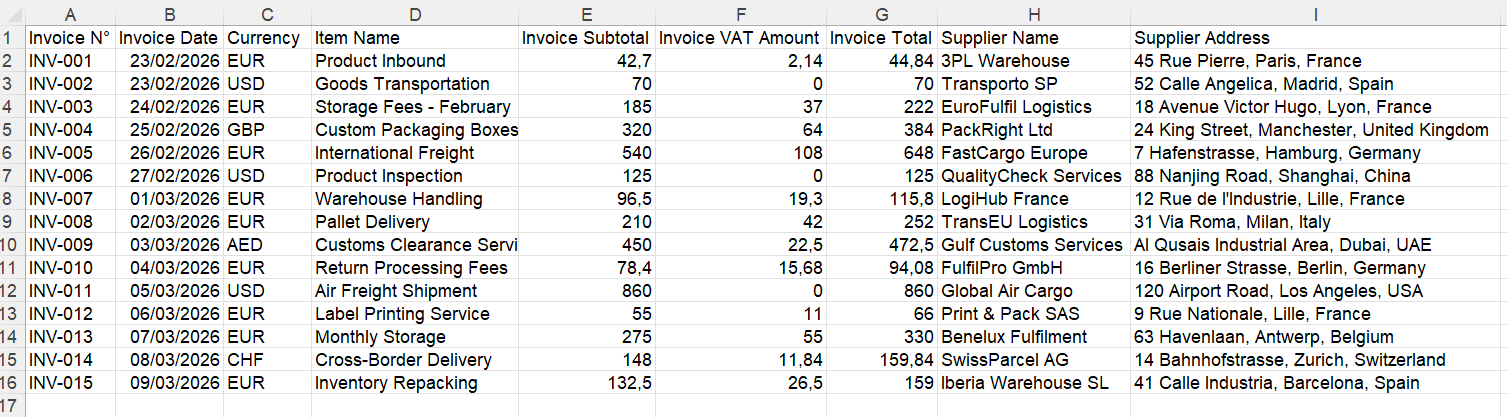
Dokumenttabelle mit englischen Überschriften. Ihre Auswahl bestimmt die Spalten.
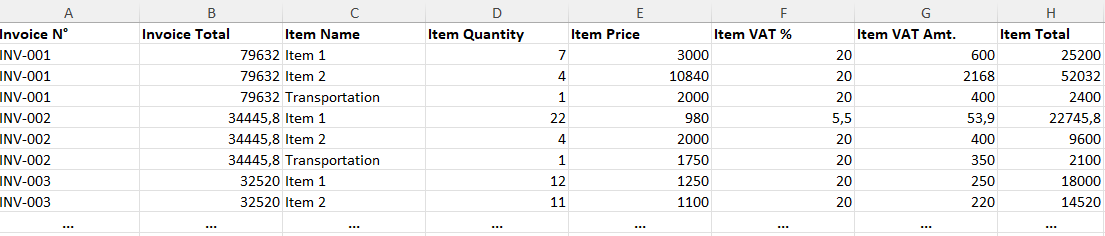
Positionstabelle mit englischen Überschriften. Addieren Sie wiederholte Dokumentbeträge nicht mehrfach.
Aktuell gibt es 20 kostenlose Extraktionen monatlich, Pro für 9 US-Dollar/Monat mit 200 Extraktionen und Business für 40 US-Dollar/Monat mit 1.000 Extraktionen. Prüfen Sie die IntoExcel-Preise und aktuellen Checkout-Bedingungen.
Geeignet als Ausgangspunkt: wenn Sie selbst eine Tabelle prüfen und verwenden möchten.
Zuerst prüfen: Ein eigenständiges Dokument pro Datei; bei Sammeldateien wird nur das erste verarbeitet. Maximal 500 Ausgabezeilen pro Datei. Fehlende Werte ergeben leere Zellen, unklare Zahlen können Text bleiben. Prüfen Sie Hinweise und Ergebnisse.
2. Adobe PDF Extract / Acrobat Services: PDF-Struktur und Tabellen
Adobe PDF Extract ist eine Entwickler-API, nicht der Acrobat-Konverter für den Desktop. Sie extrahiert Text, Formatierung, Lesereihenfolge, Abbildungen und komplexe Tabellen. Tabellendaten lassen sich zusätzlich zur strukturierten Ausgabe als CSV oder XLSX liefern.
Geeignet für: Anwendungen, die vorhandene PDF-Strukturen weiterverwenden. Die fachliche Bedeutung jeder Spalte entsteht dadurch nicht automatisch; Zuordnung und Prüfung können weiterhin nötig sein.
Preise: 500 kostenlose Document Transactions pro Monat. Bei Extract PDF zählt jeder Block von bis zu fünf Seiten als eine Transaktion. Größere kommerzielle Mengen benötigen ein Adobe-Angebot statt eines universellen öffentlichen Seitenpreises. Siehe Adobe-Entwicklerpreise.
3. Google Document AI: spezialisierte und eigene Extraktion
Google Document AI bietet OCR, Layout- und Tabellenanalyse, Prozessoren für Rechnungen, Ausgaben und Kontoauszüge sowie einen Custom Extractor, mit dem Sie Felder oder Entitäten definieren.
Ungefähre Standardpreise in USD:
| Prozessor | Abrechnungsbasis |
|---|---|
| Enterprise Document OCR | Etwa 1,50 $ je 1.000 abrechenbare Seiten |
| Layout Parser | 10 $ je 1.000 Seiten |
| Form Parser / Custom Extractor | 30 $ je 1.000 Seiten im ersten Tarifbereich |
| Invoice Parser | 0,10 $ je Dokumentblock bis zehn Seiten |
Dies sind Verarbeitungskosten, nicht die gesamte Anwendung. Freikontingente, Mengenstaffeln und Vertragsrabatte können den Betrag verändern; Hosting eigener Prozessoren und weitere Cloud-Dienste können hinzukommen. Siehe Google-Preise.
Geeignet für: Entwickler mit Bedarf an vordefinierten Prozessoren oder einem eigenen Extraktionsschema. Upload, Kontrolle und Export müssen um die API herum geplant werden.
4. Amazon Textract: Formulare, Abfragen und Rechnungen
Textract verbindet OCR mit Tabellen, Formularen und Schlüssel-Wert-Paaren, Queries und Custom Queries. AnalyzeExpense verarbeitet Rechnungen und Belege einschließlich Zusammenfassungsfeldern und Positionen. Custom Queries verwenden einen angepassten Adapter und unterscheiden sich von Standardabfragen.
Beispiele im ersten Tarifbereich für US West (Oregon), in USD:
| Operation | Preis je 1.000 Seiten |
|---|---|
| Einfache OCR: DetectDocumentText | 1,50 $ |
| Tables | 15 $ |
| Tables + Standard-Queries | 20 $ |
| Rechnungen/Belege: AnalyzeExpense | 10 $ |
Die 20 $ gelten nicht für Custom Queries. Funktionen, Region und Volumen beeinflussen die Kosten; Formulare sind im reinen Tables-Preis nicht enthalten. Diese Analysen enthalten OCR: Addieren Sie nicht automatisch eine weitere OCR-Gebühr. Siehe AWS-Preise.
Geeignet für: AWS-Anwendungen mit strukturierten Dokumentdaten. Kalkulieren Sie Integration, Speicherung und Kontrolle zusätzlich zu API-Aufrufen.
5. Tesseract OCR: kostenlose Engine, eigener Betrieb
Tesseract ist eine freie Open-Source-OCR-Engine unter Apache 2.0. Sie wandelt Bilder und Scans in maschinenlesbaren Text um. Rechnungsfelder oder die fachliche Bedeutung von Tabellen interpretiert sie nicht von sich aus; dafür benötigt Ihre Anwendung zusätzliche Logik.
Preise: Beim eigenen Betrieb fällt keine Tesseract-API-Gebühr an. Computer oder Server, Infrastruktur, Wartung und Entwicklung bezahlen Sie selbst. Ein gehosteter Drittanbieterdienst kann eigene Gebühren verlangen.
Geeignet für: einfache OCR mit lokalem Betrieb und geringen direkten Verarbeitungskosten. Bei vorhandener Technik und Erfahrung kann das wirtschaftlich sein, ist aber nicht automatisch der günstigste vollständige Rechnungsprozess. Die native Ausgabe ist keine XLSX-Geschäftstabelle.
Gesamtkosten vergleichen
Die Beträge sind am 21. September 2026 geprüfte Richtwerte, keine Angebote für Ihre Anwendung. Vergleichen Sie gleiche Mengen und Ergebnisse. Seite, Adobe-Transaktion, IntoExcel-Extraktion und Monatsabonnement sind verschiedene Einheiten.
Berücksichtigen Sie Einrichtung, gegebenenfalls Hosting, Korrektur, Kontrolle und Integration. Prüfen Sie aktuelle regionale Tarife und Abrechnungsbedingungen vor dem Kauf.
Vor der Auswahl praktisch testen
Nutzen Sie dieselben repräsentativen Dateien und Zielspalten:
- Lesbare Scans, digitale PDFs und typische Layouts einbeziehen.
- Referenzen, Daten, Beträge und Positionszahlen am Original prüfen.
- Den Export öffnen und Berechnungen sowie führende Nullen testen.
- Fehlende oder falsche Werte und nötige Korrekturen notieren.
- Den gesamten Aufwand vergleichen, nicht nur den Upload.
Ein hypothetischer Pilot könnte zehn typische Dokumente umfassen. Das ist ein Testvorschlag, keine Geschwindigkeits- oder Genauigkeitsbehauptung.
Für PDF- oder Rechnungsdaten in einer gewählten Excel-Struktur beginnen Sie mit der IntoExcel-Extraktion. Prüfen Sie eine kleine Auswahl und entscheiden Sie dann, ob Felder und Zeilenmodi passen.
Bereit, es selbst auszuprobieren?
Sparen Sie sich stundenlange manuelle Dateneingabe. Extrahieren Sie Ihre PDF-Daten mit unserem KI-Tool direkt nach Excel.
Extraktion